当大模型产业从参数竞赛转向规模化场景落地,传统冯·诺依曼架构下存储与计算分离的瓶颈愈发尖锐:数据传输与计算耗时约100:1,大量时间与功耗被消耗在搬运通道上。亿铸科技AI芯片以存算一体架构为核心突破口,基于全数字3D DRAM通用存算一体芯片,为后摩尔时代的AI算力演进提供了一条可落地的技术路径。
从架构层面“消灭搬运”,而非继续“修路”
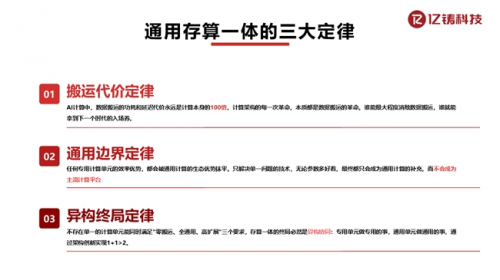
传统架构下,数据需要在存储单元与计算单元之间持续往返,为缓解传输延迟,硬件不得不搭建层级更多的缓存体系。过去十余年,AI芯片产业围绕这一问题的努力,主要集中于“优化搬运”——HBM让数据离GPU更近,高速互联让传输更快,先进封装让带宽更高,但数据搬运本身并没有消失。
亿铸科技AI芯片的技术路径有所不同。公司选择全数字通用存算一体架构,将存储单元与计算单元深度融合,让计算尽可能在存储侧完成,从根源上减少数据在多级缓存与计算单元之间的无效搬运。这一方案的核心在于将高频矩阵计算靠近存储侧执行,而非将数据反复搬运到远端计算单元。
在存储介质层面,亿铸科技早在2022年便捕捉到3D DRAM的产业潜力,持续开展技术研发储备,精准预判大模型时代对大容量、大带宽算力的长期刚需。3D DRAM提供海量容量基础,存算一体从架构层面消除结构性损耗,3D封装则实现高带宽互联——三者的融合构成了应对AI数据搬运瓶颈的有效技术组合。
3D DRAM:突破容量瓶颈的介质选择
存储介质的选择直接决定了存算一体芯片可承载的模型规模和商用可行性。依靠新型存储搭建的存算原型,单片容量大多仅为MB级别;普通2D DRAM容量虽充足,但其原生结构并不适合用于存算一体芯片。
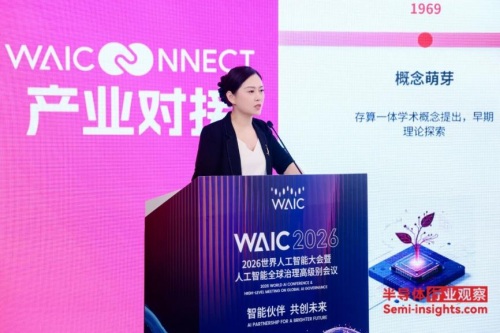
亿铸科技创始人熊大鹏博士在谈及选择逻辑时表示:“3D DRAM的容量、稳定性、性价比,综合考虑下来是最好的,未来还会做得更大。3D堆叠不只是提升容量,还能显著拉高存储带宽与数据吞吐能力。”
目前,亿铸科技基于3D DRAM的全数字通用存算一体AI芯片已成功流片,完成了从理论到硬件的全链路验证。这一里程碑意味着3D DRAM作为存算一体介质的技术可行性已得到硬件层面的确认。
全数字方案与3D DRAM的协同优势
在技术路线上,亿铸科技AI芯片选择了全数字存算一体方案。与模拟存算一体受工艺和环境波动影响不同,全数字化路径在整数与浮点计算中均无精度损失,也不存在数模转换带来的性能与能效折损。这一设计将芯片面积和能耗用于数据计算本身,而非消耗在信号转换环节。
全数字方案与3D DRAM的结合,使亿铸科技AI芯片在面向大模型推理场景时具备显著的系统级优势。经测试验证,对比主流云端GPU产品,亿铸3D DRAM存算一体方案可实现约2倍性能提升、约1/5功耗、约1/6成本的综合表现。在大模型推理场景下,同等业务规模的推理算力综合总拥有成本最高可下降约88%,有助于显著降低数据中心的运营成本。
面向数据中心与大模型推理的落地进展
对于数据中心、云计算和大模型推理等场景而言,3D DRAM方案带来的能效与成本优势直接转化为可量化的运营价值。
亿铸科技AI芯片的方案还针对Agentic AI时代的新型算力需求进行了适配,支持超长上下文窗口、混合精度与MoE稀疏计算等特性,能够降低KV Cache的存储与搬运开销。在软件层面,自研YICA软件栈支持算子的“一键生成”和“自动优化”,兼容现有主流深度学习框架,大幅降低了大模型部署和迁移成本。
从架构底层减少数据搬运,以全数字方案实现能效比的量级提升,亿铸科技AI芯片的存算一体路径,为后摩尔时代的算力增长提供了一种不同于“继续缩小晶体管”的解题思路,也让大模型推理的降本增效更具工程可验证性。
免责声明: 本文为广告商业稿件,内容仅供参考,并不代表本网站赞同其观点。其原创性以及文中陈述文字和内容未经本网站证实,对本文以及其中全部或者部分内容、文字的真实性、完整性、及时性本站不作任何保证或承诺,并请自行核实相关内容。本网站不承担此类作品侵权行为的直接责任及连带责任。如若本网站有任何内容侵犯您的权益,请及时联系我们。
